


Weniger Zeit gebraucht und bessere Vorbereitung für Associate-Developer-Apache-Spark-3.5 getroffen
Wir wissen, dass viele Prüfungskandidaten haben nicht viel Zeit für die Vorbereitung auf diese IT-Zertifizierungsprüfung. Allerdings bietet das Zertifikat der Associate-Developer-Apache-Spark-3.5 viele Vorteile. Deshalb machen wir den Lernstoff der Associate-Developer-Apache-Spark-3.5 sehr leicht zu benutzen. Die Fragen von unserer Test-Bank sind umfassend und typisch. Sie brauchen nicht selbst Prüfungsunterlagen für Associate-Developer-Apache-Spark-3.5 suchen oder Kurs für IT-Zertifizierungstest besuchen. Jede Prüfungsfrage der Associate-Developer-Apache-Spark-3.5 hat nicht nur richtige Antwort darauf, sondern auch leicht zu verstehende Erklärungen.
Wir garantieren Ihnen, wenn Sie die simulierende Prüfung der Associate-Developer-Apache-Spark-3.5 von uns bestehen können, haben Sie schon sehr hohe Möglichkeit, die Zertifizierung zu bestehen. Wenn Sie alle Übungen ernsthaft gemacht haben, Ihr Erfolg bei Associate-Developer-Apache-Spark-3.5 sind bestimmt garantiert.
Anspruchsvolle Dienstleistungen genießen, Associate-Developer-Apache-Spark-3.5 am besten benutzen
Auf unserer Website bieten wir mehrsprachige Online-Service. Sie können direkt Informationen über Prüfungsunterlagen der Associate-Developer-Apache-Spark-3.5 erfahren. Weil jede Version ihre eigene Überlegenheit hat, empfehlen wir, dass Sie vor dem Kauf zuerst Demos aller drei Versionen probieren. Oder Sie können einfach 3 Versionen von Associate-Developer-Apache-Spark-3.5 zusammen genießen. In diesem Fall können Sie größeren Rabatt genießen.
Nach dem Kauf genießen Sie noch einjährigen Aktualisierungsdienst der Prüfungsunterlagen der Associate-Developer-Apache-Spark-3.5 ohne zusätzliche Gebühren. Die neuesten Materialien werden automatisch zu Ihnen per E-Mail geschickt.
Wir nehmen Ihre Ergebnisse der Zertifizierungsprüfung sehr ernst. Sie können Ihre Freude über den Erfolg bei Associate-Developer-Apache-Spark-3.5 mit uns teilen. Wir werden auch für Ihren Verlust verantwortlich sein. Falls Sie leider beim Test der Associate-Developer-Apache-Spark-3.5 durchfallen, wir bieten Sie volle Erstattung. Alles in allem hoffen wir herzlich, dass Sie mit unseren Unterstützungen diese wichtige IT-Zertifizierung Associate-Developer-Apache-Spark-3.5 zügig bestehen und großen Fortschritt bei der Arbeit machen!
Einfach und bequem zu kaufen: Um Ihren Kauf abzuschließen, gibt es zuvor nur ein paar Schritte. Nachdem Sie unser Produkt per E-Mail empfängen, herunterladen Sie die Anhänge darin.
Zuverlässige Prüfungsunterlagen der Associate-Developer-Apache-Spark-3.5
Die Fragen und Antworten in den Prüfungsunterlagen von unserer Website sind echte Prüfungsfragen von den Zertifizierungstesten der Associate-Developer-Apache-Spark-3.5. Unsere IT-Profis haben seit Jahren eine große Menge von wichtigen Materialien der Associate-Developer-Apache-Spark-3.5 gesammelt und logisch geordnet. Sobald neue Prüfungsfragen in der letztesten Zertifizierungsprüfung erscheinen, werden wir sofort die Software oder andere Unterlagen für die Associate-Developer-Apache-Spark-3.5 aktualisieren, um den verlässlichen Lernstoff zu bieten.
Über 98% unserer Benutzer haben die Zertifizierung der Associate-Developer-Apache-Spark-3.5 bestanden. Darauf sind wir sehr stolz. Sie sind ganz zufrieden mit unseren Prüfungsmaterialien der Associate-Developer-Apache-Spark-3.5. Wir glauben, dass mit dem Zertifikat der Associate-Developer-Apache-Spark-3.5 sie bessere Berufsperspektive in der IT-Branche bekommen können.

Databricks Associate-Developer-Apache-Spark-3.5 Prüfungsthemen:
| Abschnitt | Ziele |
|---|---|
| DataFrame-API mit PySpark | - Integrierte Funktionen und Ausdrücke - Erstellung von DataFrames und Verwaltung von Schemas - Transformationen und Aktionen |
| Datenaufnahme und Speicherung | - Grundlagen von Delta Lake - Lesen und Schreiben von Daten (Parquet, JSON, CSV) |
| Apache Spark Grundlagen | - Spark-Architektur und Ausführungsmodell - Konzepte von RDD, DataFrame und Dataset im Vergleich |
| Spark SQL | - Fensterfunktionen und Aggregationen - SQL-Abfragen auf DataFrames und Tabellen |
| Datenverarbeitung und Leistung | - Optimierungsverfahren - Strategien zur Zwischenspeicherung und dauerhaften Speicherung - Verknüpfungen und Datenpartitionierung |
| Grundlagen von Structured Streaming | - Fensterbasierte Aggregationen im Streaming-Betrieb - Streaming DataFrames |
Databricks Certified Associate Developer for Apache Spark 3.5 - Python Associate-Developer-Apache-Spark-3.5 Prüfungsfragen mit Lösungen
A developer needs to produce a Python dictionary using data stored in a small Parquet table, which looks like this: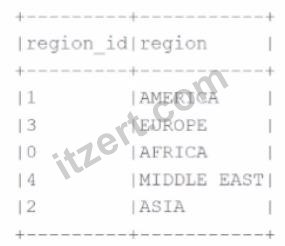
The resulting Python dictionary must contain a mapping of region -> region id containing the smallest 3 region_id values.
Which code fragment meets the requirements?
A)
B)
C)
D)
The resulting Python dictionary must contain a mapping of region -> region_id for the smallest 3 region_id values.
Which code fragment meets the requirements?
- A. regions = dict(
regions_df
.select('region', 'region_id')
.sort(desc('region_id'))
.take(3)
) - B. regions = dict(
regions_df
.select('region_id', 'region')
.limit(3)
.collect()
) - C. regions = dict(
regions_df
.select('region', 'region_id')
.sort('region_id')
.take(3)
) - D. regions = dict(
regions_df
.select('region_id', 'region')
.sort('region_id')
.take(3)
)
Antwort: C 🗳️
Erklärung: (Nur für ITZert-Mitglieder sichtbar)
54 of 55.
What is the benefit of Adaptive Query Execution (AQE)?
- A. It automatically distributes tasks across nodes in the clusters and does not perform runtime adjustments to the query plan.
- B. It enables the adjustment of the query plan during runtime, handling skewed data, optimizing join strategies, and improving overall query performance.
- C. It optimizes query execution by parallelizing tasks and does not adjust strategies based on runtime metrics like data skew.
- D. It allows Spark to optimize the query plan before execution but does not adapt during runtime.
Antwort: B 🗳️
Erklärung: (Nur für ITZert-Mitglieder sichtbar)
A data engineer is building a Structured Streaming pipeline and wants the pipeline to recover from failures or intentional shutdowns by continuing where the pipeline left off.
How can this be achieved?
- A. By configuring the option checkpointLocation during readStream
- B. By configuring the option recoveryLocation during the SparkSession initialization
- C. By configuring the option recoveryLocation during writeStream
- D. By configuring the option checkpointLocation during writeStream
Antwort: D 🗳️
Erklärung: (Nur für ITZert-Mitglieder sichtbar)
An engineer has a large ORC file located at /file/test_data.orc and wants to read only specific columns to reduce memory usage.
Which code fragment will select the columns, i.e., col1, col2, during the reading process?
- A. spark.read.format("orc").load("/file/test_data.orc").select("col1", "col2")
- B. spark.read.orc("/file/test_data.orc").selected("col1", "col2")
- C. spark.read.format("orc").select("col1", "col2").load("/file/test_data.orc")
- D. spark.read.orc("/file/test_data.orc").filter("col1 = 'value' ").select("col2")
Antwort: A 🗳️
Erklärung: (Nur für ITZert-Mitglieder sichtbar)
A data engineer is working on the DataFrame:
(Referring to the table image: it has columns Id, Name, count, and timestamp.) Which code fragment should the engineer use to extract the unique values in the Name column into an alphabetically ordered list?
- A. df.select("Name").distinct().orderBy(df["Name"].desc())
- B. df.select("Name").orderBy(df["Name"].asc())
- C. df.select("Name").distinct()
- D. df.select("Name").distinct().orderBy(df["Name"])
Antwort: D 🗳️
Erklärung: (Nur für ITZert-Mitglieder sichtbar)
 991 Kundenrezensionen


Hofmannsthal -
Diese Schulungsunterlagen sind sehr wertvoll, denn ich habe meine Prüfung Associate-Developer-Apache-Spark-3.5 damit bestanden. Prüfungsmaterial ITZert ist am Wichtigsten während der Vorbereitung für die Prüfung Associate-Developer-Apache-Spark-3.5.